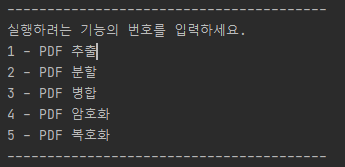
Python으로 PDF 추출, 분할, 병합, 암호화, 복호화 커맨드 버전의 예제 코드이다.
각 기능은 다음과 같다.
- 추출 : 특정 페이지만 추출
- 분할 : 특정 페이지마다 분리
- 병합 : 여러 PDF 파일 합치기
- 암호화/복호화 : PDF 파일 암호 설정 및 해제
참고로,
PDF 추출/분할/병합은 PyPDF2 라이브러리 위주로 동작하고
PDF 암호화/복호화는 pikepdf 라이브러리 위주로 동작한다.
PyPDF2도 암호화가 가능하긴 한데 생각보다 원하는대로 동작하지 않았다.
그래서 부득이하게 암호화 및 복호화는 pikepdf 라이브러리 위주로 동작하게끔 구성했다.
전체코드
import os
from glob import glob
from PyPDF2 import PdfFileReader, PdfFileWriter, PdfFileMerger      # pip install PyPDF2
from natsort import natsorted                                       # pip install natsort
import pikepdf                                                      # pip install pikepdf


"""
PDF Extract Function
"""
def PdfExtract():
    nameExtract = str(input('추출하려는 PDF 파일 이름을 입력하세요. 예) Test\r\n'))
    nameExtract += '.pdf'
    noExtract = int(input('추출하려는 페이지를 입력하세요.\r\n'))

    # PDF 파일 읽기
    pdfReader = PdfFileReader(nameExtract, "rb")

    # PDF Writer 생성
    pdfWriter = PdfFileWriter()

    # 입력받은 페이지를 PDF Writer에 저장
    # Index가 0부터 시작하기 때문에, getPage() 함수의 파라미터에서 noExtract 변수보다 1을 빼야함
    pdfWriter.addPage(pdfReader.getPage(noExtract-1))

    # 파일명과 확장자명 분리 후, 파일명 추출
    nameExtract = os.path.splitext(nameExtract)[0]
    nameExtract = './' + nameExtract + '_' + str(noExtract) + '.pdf'

    # 기존파일명_추출번호.pdf로 PDF파일 추출
    pdfWriter.write(open(nameExtract, "wb"))


"""
PDF Split Function
"""
def PdfSplit():
    nameSplit = str(input('분할하려는 PDF 파일 이름을 입력하세요. 예) Test\r\n'))
    nameSplit += '.pdf'
    noSplit = int(input('분할의 기준이 되는 페이시 수량을 입력하세요. 예) 2 -> 2페이지씩 분할 .\r\n'))

    # PDF 파일 읽기
    pdfReader = PdfFileReader(nameSplit, "rb")

    # PDF 파일 총 페이지 수 읽기
    totalPage = pdfReader.getNumPages()

    # 총 페이지수 / 분할 페이지 수의 정수형 몫과 나머지
    quotient = totalPage // noSplit
    remainder = totalPage % noSplit

    # 총 페이지 수 만큼 반복, Indexing 계산을 편하게 하기 위해 1부터 총페이지+1 만큼 반복
    for i in range(1, totalPage+1):

        # 나머지가 1이면, 분할하려는 첫 페이이고 PDF Writer 객체를 새로 생성하고 현재의 Page를 저장
        if i % noSplit == 1:
            pdfWriter = PdfFileWriter()
            noStartPage = i

        # 모든 페이지마다 PDF Writer에 복사
        page = pdfReader.getPage(i - 1)
        pdfWriter.addPage(page)

        # 분할 페이지 구간이거나 최대 페이지라면 새로운 PDF 파일을 생성하고 마지막 Page를 저장
        if i % noSplit == 0 or i == totalPage:
            noEndPage = i

            # 파일명과 확장자명 분리
            nameSplit = os.path.splitext(nameSplit)[0]

            # 분할의 시작과 끝이 다르면
            if noStartPage != noEndPage:
                file = './' + nameSplit + '_' + str(noStartPage) + '-' + str(noEndPage) + '.pdf'
                pdfWriter.write(open(file, "wb"))

            # 분할의 시작과 끝이 다르면
            else:
                file = './' + nameSplit + '_' + str(noStartPage) + '.pdf'
                pdfWriter.write(open(file, "wb"))


"""
PDF Merge Function
"""
def PdfMerge():
    nameMerge = str(input('병합하려는 PDF 파일 이름의 PreFix를 입력하세요. 예) Test\r\n'))

    # PDF FileMerger 객체 생성
    pdfMerger = PdfFileMerger()

    # PreFix_ 형태의 이름을 가진 .pdf 파일들을 모두 읽기
    iPath = glob(nameMerge + '_*.pdf')

    # 문자열+숫자 조합 정렬
    iPath = natsorted(iPath)

    # 모든 파일을 PDF FilerMerger에 추가
    for f in iPath:
        pdfMerger.append(f)

    # 병합된 pdf 파일 생성
    pdfMerger.write(nameMerge + "_merge.pdf")
    pdfMerger.close()


"""
PDF Encryption Function
"""
def PdfEncryption():
    nameEncrypt = str(input('비밀번호를 추가하려는 PDF 파일 이름을 입력하세요. 예) Test\r\n'))
    nameEncrypt += '.pdf'
    pwEncryption = input('추가하려는 비밀번호를 입력하세요.\r\n')

    # PDF 파일 읽기
    iPdf = pikepdf.Pdf.open(nameEncrypt)

    # pikepdf Permissions 설정값 저장
    no_extracting = pikepdf.Permissions(extract=False)

    # 파일명과 확장자명 분리 후, 파일명 추출
    nameEncrypt = os.path.splitext(nameEncrypt)[0]
    nameEncrypt += '_encrypt.pdf'

    # 읽었던 PDF 파일에 입력받은 비밀번호를 추가하여 PDF 파일 생성
    iPdf.save(nameEncrypt, encryption=pikepdf.Encryption(
        user = pwEncryption, owner = pwEncryption, allow = no_extracting
    ))


"""
PDF Decryption Function
"""
def PdfDecryption():
    nameDecrypt = str(input('비밀번호를 제거거하려는 PDF 파일 이름을 입력하세요. 예) Test\r\n'))
    nameDecrypt += '.pdf'
    pwDecryption = input('해당파일의 비밀번호를 입력하세요.\r\n')

    # PDF 파일 읽기
    iPdf = pikepdf.Pdf.open(nameDecrypt, password=pwDecryption)

    # 새로운 pikepdf 객체 생성
    oPdf = pikepdf.Pdf.new()

    # 모든 페이지를 새로운 pikepdf 객체에 저장
    for n, page in enumerate(iPdf.pages):
        oPdf.pages.append(page)

    # 파일명과 확장자명 분리 후, 파일명 추출
    nameDecrypt = os.path.splitext(nameDecrypt)[0]
    nameDecrypt += '_decrypt.pdf'

    # 새로운 pikepdf 객체에 담긴 내용으로 PDF 파일 생성
    oPdf.save(nameDecrypt)


"""
Main Function
"""
def main():
    while(1):
        print('\r\n')
        print('----------------------------------------')
        print('실행하려는 기능의 번호를 입력하세요.')
        print('1 - PDF 추출')
        print('2 - PDF 분할')
        print('3 - PDF 병합')
        print('4 - PDF 암호화')
        print('5 - PDF 복호화')
        print('----------------------------------------')
        print('\r\n')

        noFunction = int(input())

        if noFunction == 1:
            PdfExtract()
        elif noFunction == 2:
            PdfSplit()
        elif noFunction == 3:
            PdfMerge()
        elif noFunction == 4:
            PdfEncryption()
        elif noFunction == 5:
            PdfDecryption()
        else:
            print('잘못 입력하셨습니다.')


if __name__ == "__main__":
	main()
댓글을 불러오고 있습니다.